L’essentiel de l’actualité technologique

Le Fil Tech

Artificial Analysis lance l’Intelligence Index v5, avec de nouveaux benchmarks en programmation et en sciences, élaborés à partir de jeux de données privés
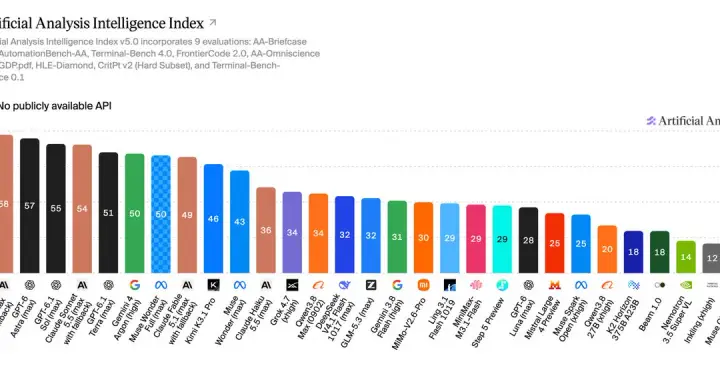
Présentation de l’Artificial Analysis Intelligence Index v5, avec 2 nouveaux benchmarks et 3 améliorations. Pour la première fois, la majorité de l’Index repose sur des jeux de données privés. L’Artificial Analysis Intelligence Index est notre mesure composite des capacités des modèles dans différentes tâches, qui reflètent des usages réels...

Plus de couverture

Sur X

  • @artificialanlys · FrontierCode 2.0 est la dernière mise à jour du benchmark de programmation privé de @cognition. Lancé plus tôt dans la journée, il comprend 132 tâches dans de vrais dépôts open source, évaluées selon qu’un mainteneur fusionnerait ou non les modifications de l’agent. Une tentative qui échoue à un contrôle bloquant obtient 0, et les tâches restent priva...
  • @artificialanlys · Terminal-Bench-Science évalue la capacité des agents à mener des workflows de recherche scientifique dans un terminal. Des experts sélectionnent et examinent chaque tâche, qui n’est réussie que si tous ses tests sont validés. GPT-6 Astra (max) est en tête avec 63 %, suivi de Claude Opus 5.5 (max) à 59 % et de GPT-6.1 Sol (max) à 58 %...
  • @artificialanlys · Les modèles à poids ouverts sont encore plus à la traîne dans la v5. Le leader, Kimi K3.1 Pro (dont les poids n’ont pas encore été publiés), obtient 46 points, soit 12 points de moins que le leader, contre un écart de 3 points dans la v4.3. Parmi les modèles dont les poids sont disponibles, DeepSeek V4.1 Flash 1017 (max) et GLM-5.3 (max) obtiennent les meilleurs scores, avec 32 points, et Claude Haiku 5...
  • Ethan Mollick / @emollick · Artificial Analysis passe enfin à des benchmarks fermés (adieu GDPval-AA) et constate que les modèles à poids ouverts prennent encore plus de retard qu’ils ne l’avaient mesuré auparavant. À prendre avec des pincettes, mais ça correspond à l’impression générale : on n’a pas vu de modèle open de la classe de Fable.
  • Ziwen / @ziwenxu_ · Le benchmaxxing pourrait être mort pour des années ; les labos d’IA pourraient entraîner leurs modèles sur les questions des tests …
  • Ahmad / @theahmadosman · Je me fiche de ce que dit AA, DeepSeek v4.1 Flash 1017 est le SoTA des modèles à poids ouverts et c’est pratiquement un Opus 5.3 s’il existait lol
  • @llmjunky · C’est fascinant. Il s’avère que quand on cesse de rendre les benchmarks publics, les modèles open obtiennent des résultats nettement moins bons. Pour moi, Deepseek 4.1 Flash et GLM 5.3 ont été une révélation incroyable, ces modèles sont tellement bons. Mais quand ces labos/ces gens essaient de me vendre l’idée qu’on a...
  • @theo · Slopalytics a été mis à jour avec les nouvelles données d’Artificial Analysis. Ça change considérablement la frontière de Pareto.
  • @scaling01 · C’est probablement la meilleure version à ce jour.
  • @da7_tech · Je ne peux pas faire confiance à un benchmark qui classe Grok, Gemini, Terra et Muse bien au-dessus de DeepSeek Flash, et de loin.
  • Nathan Lambert / @natolambert · La disparition des modèles ouverts a été largement exagérée, mais le précédent indice AA leur était effectivement favorable. En tant que secteur, nous avons besoin d'indices d'intelligence plus spécifiques, car les LLM sont utilisés pour des tâches très différentes. Mon analyse critique du secteur de l'évaluation comparative. https://www.interconnects.ai/ ...
  • Layton Gott / @layton_gott · Voir Grok 4.7 aussi bas, c’est vraiment triste... SpaceX a plus que jamais besoin de Grok 4.8. Mais même Grok 4.8 ne sera pas en tête du classement, Elon a déjà dit qu’il ne serait pas à la hauteur d’Astra ou de Fable. Alors, à quoi sert vraiment la version 4.8 ? Je mise sur Grok Bot, puisque Elon a dit que la plupart des requêtes de Grok Bot tourneront sur une versi...
  • Alex Corrino / @alexcorrino · C’est crucial à comprendre. Les modèles à poids ouverts sont nuls et sont fortement optimisés pour les benchmarks, quoi qu’en disent les gourous ici.
  • Mert Gulsun / @mert_gulsun · La plus grosse mise à jour de notre index est arrivée ! Fini les évaluations saturées, place à une majorité de jeux de données privés et à des tâches entièrement nouvelles ! La science et les systèmes complexes sont au premier plan. Un immense merci à toutes et à tous pour vos retours et votre soutien. Nous vous écoutons très attentivement et votre expérience guide nos recherches. Jusqu’à la singularité,...
  • Dean W. Ball / @deanwball · C’est la première fois qu’un classement d’Artificial Analysis se rapproche, même approximativement, de mon propre classement subjectif des modèles.
  • @brandonmusicky · Ces chiffres sont complètement bidon. Rien ne justifie de faire baisser les scores des modèles OSS tout en laissant ceux des modèles américains fermés pratiquement inchangés. J’ai vraiment perdu confiance en ces gens.
  • Chris / @chrisgpt · Artificial intelligence Analysis vient de publier son nouvel index : aucun labo n’obtient la moyenne. Je trouve intéressant que GPT 6.1 Terra batte Gemini 4 Argon ; je vais peut-être essayer davantage Terra ? [image] [publication citée]
  • @aibattle_ · L’AA-Intelligence Index est passé à la V5. Classement précédent : 1. Claude Opus 5.5 (Max) - 58 2. Claude Sonnet 5.5 (Max) - 56 3. Muse Wonder Full (Max) - 56 4. Kimi K3.1 Pro - 55 5. Claude Fable 5.1 (Max) - 53 Nouveau classement : 1. Claude Opus 5.5 (Max) - 58 2. GPT-6-Astra (Max) - 57 3. GPT-6.1-Sol...
  • @harshithlucky3 · J’ai un très mauvais pressentiment au sujet de ce nouvel AA Intelligence Index v5. Selon ce benchmark : GPT 6.1 Sol > Sonnet 5.5 GPT 6.1 Terra et Sol > Claude Fable 5.1 et Gemini 4 Argon C’est très favorable à OpenAI [image] [publication citée]
  • Dax / @thdxr · Peu de gens misent autant que nous sur les modèles open source, mais il est important de rester réaliste quant à leur niveau et à la demande. Il y a encore un grand écart. Ils occupent une place intéressante sur le marché, mais trop de gens agissent comme s’ils étaient sur le point de détrôner les modèles de pointe
  • @acerfur · Pour la première fois depuis longtemps, l’AA Index correspond vraiment à mon expérience lol [publication citée]
  • Maria / @maria_rcks · Ça passe le test du bon sens, mais Argon est beaucoup trop haut à mon goût [publication citée]
  • Zvi Mowshowitz / @thezvi · D’accord, tout s’explique beaucoup mieux maintenant.
  • @da7_tech · Terra au-dessus de Fable ?! ! Qu’est-ce que tu fumes ?
  • @kimmonismus · L’Intelligence Index v5 d’Artificial Analysis fonde désormais 60 % de son score sur des évaluations avec des jeux de test privés ou des réponses réservées, Claude Opus 5.5 devançant de peu GPT-6 Astra et GPT-6.1 Sol. Comme prévu, GPT-6-Astra semble actuellement légèrement en avance dans les benchmarks scientifiques, tandis qu’Opus 5...
  • AshutoshShrivastava / @ai_for_success · D’après le nouvel Artificial Analysis Intelligence Index v5, GPT 6.1 Terra Max est meilleur que Gemini 4 Argon High. J’en ai assez de ces conneries. [image] [publication citée]
  • @shownotover · WTF ? ! GPT-6 Astra n’a pas réussi à battre Fable 5.1, et maintenant il rivalise avec Opus 5.5 ??! ! C’est FAUX ! ! J’ai utilisé les deux modèles pendant plus de 10 milliards de tokens chacun, je sais pertinemment qu’Astra n’arrive même pas à ce niveau. Même Sonnet 5.5 est meilleur qu’Astra [publication citée]

Sur les forums

Newsletter

L’essentiel du Fil

Recevez l’essentiel de l’actualité tech chaque matin dans votre boîte mail gratuitement.