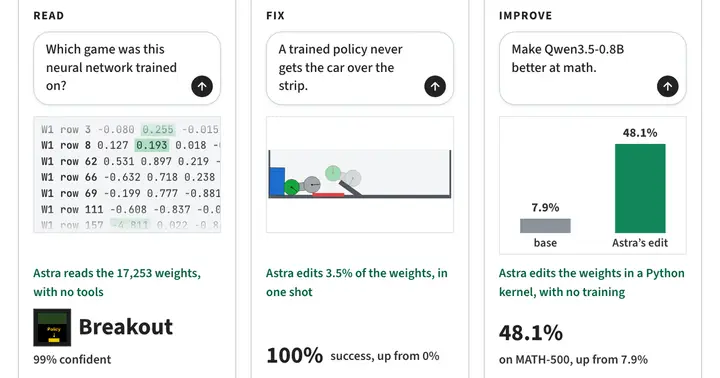
En bref… Si l’on vous demandait de concevoir à la main un réseau neuronal capable de jouer au Go, que feriez-vous ? Et si l’on vous remettait les poids bruts d’un réseau neuronal…
John Renaldi · Putain de merde. — Astra a trouvé comment lire nativement les réseaux neuronaux. Ce qui pourrait être super intéressant pour résoudre le problème de l’alignement…
Sur X
Alex Krentsel / @alexkrentsel · j'ai reproduit aujourd'hui les résultats de l'article du blog du MIT sur la programmation dans l'espace des poids. mais j'ai un résultat supplémentaire à ajouter : c'est une nouvelle capacité émergente, un véritable changement de cap, apparue avec les tout derniers modèles.
@kimmonismus · Absolument incroyable : des chercheurs du MIT affirment que GPT-6 Astra a fait passer le score en maths d’un petit modèle Qwen de 7,9 % à 48,1 % en modifiant directement seulement 0,016 % de ses poids, sans entraînement fondé sur le gradient. Ce résultat ouvre la voie à des systèmes d’IA capables de diagnostiquer et d’améliorer directement d’autres modèles, une avancée potentielle vers une IA qui s’améliore elle-même. [publication citée]
Rikiya Takehi / @rikiyatakehi · Nous avons demandé à GPT-6 Astra de modifier les poids de Qwen3.5-0.8B pour améliorer ses performances en maths. Il n’a modifié directement que 0,016 % des poids, corrigeant les boucles de raisonnement de la version 0.8B et améliorant les performances en maths jusqu’à 6 fois, ainsi que le suivi des instructions jusqu’à 3 fois, sans gradient ni entraînement. Nous appelons cela la programmation dans l’espace des poids : les LLM de pointe peuvent désormais nati...
Yuchen Jin / @yuchenj_uw · C’est sacrément cool ! Imaginez utiliser un grand LLM pour modifier directement les poids d’un modèle plus petit et améliorer considérablement ses capacités. C’est comme de l’édition génétique pour les réseaux de neurones. Encore plus cool que la distillation ! [publication citée]
Neel Nanda / @neelnanda5 · C'est un article intéressant, mais je pense qu'il vaut mieux voir cela comme la capacité étonnante d'Astra à mener des recherches classiques en interprétabilité mécanistique, plutôt que comme quelque chose de mystérieux. Ce qu'elle fait est astucieux, mais consiste généralement à exploiter la structure des données et à utiliser des méthodes connues d'interprétabilité mécanis...
@tenobrus · je n’ai pas encore lu ce billet et ne peux pas dire si les résultats précis présentés ici sont exacts ni si l’approche peut passer à l’échelle. mais je pense qu’il faut vraiment s’attendre à voir *quelque chose de ce genre* se produire dans l’année qui vient, et que ce sera l’un des facteurs moteurs de l’RSI, et potentiellement d’une RSI très rapide. dans...
@nrehiew_ · Astra, mon modèle est nul. Répare-le. Ne fais aucune erreur.
Omar Khattab / @lateinteraction · vous pensiez que les LLM ne pouvaient faire que de l’optimisation et de la découverte textuelles pour les prompts, les harness et le code ? il s’avère qu’ils commencent aussi à savoir raisonner directement sur les poids des réseaux de neurones et à les écrire eux-mêmes. à terme, qu’adviendra-t-il des heuristiques symboliques d’optimisation locale comme grad...
Ramez Naam / @ramez · Découverte fascinante ! Astra peut interpréter la fonction de modèles plus petits en se contentant d’examiner leurs poids. Et elle peut corriger les défauts de modèles plus petits. C’est une nouvelle encourageante à la fois pour l’interprétabilité mécanistique et la surveillance de l’IA, et pour la RSI. À noter : les modèles améliorés par Astra étaient de 1 000 à 58 millions de fois plus petits qu’elle. [publication citée]
Roon / @tszzl · quand on voit des « étincelles » d’une capacité dans les modèles d’IA, ça veut dire qu’ils seront surhumains dans ce domaine d’ici quelques mois ou quelques années. aujourd’hui, les maths de niveau primaire ; demain, les équations de navier-stokes. il est difficile d’exagérer ces résultats. quoi qu’on en dise, on les sous-estime presque toujours
@martin_casado · Oh wow. Reproduction de l’article de blog du MIT. Regardez ce changement radical. Ça doit être un effet des efforts déployés dans les labos pour atteindre la RSI, non ?
Karen Zhou / @karenzzhou · la programmation dans l'espace des poids, c'est cool, mais : 1. le petit modèle n'était pas mauvais en maths, il était juste coincé à se répéter dans 93 % des problèmes. astra a trouvé la boucle et l'a interrompue 2. la même correction a amélioré le suivi des instructions de 3x, parce qu'un modèle qui boucle échoue pratiquement à tout 3. sur un modèle qui ne bouclait pas,...
Yuchen Jin / @yuchenj_uw · Prédictions (folles) après les travaux du MIT d'aujourd'hui sur la programmation dans l'espace des poids : 1. Les poids des modèles deviennent un langage de programmation que l'IA peut comprendre, mais pas les humains. 2. L'entraînement et l'inférence vont fusionner. Comme le cerveau humain, l'IA pourrait réécrire continuellement ses propres poids pendant qu'elle réfléchit. 3. Une nouvelle voie vers la RSI :...
Alex Zhang / @a1zhang · l’une des idées qui m’intéressent le plus, à la PRH, c’est la possibilité qu’on puisse initialiser rapidement de nouvelles architectures de LM à froid, à partir de modèles existants déjà entraînés, et utiliser des LLM pour remplir les poids de nouvelles formes de modèles arbitraires en fonction de ce qu’on aura découvert ici, plutôt que de préentraîner sur le même corpus...
@dummerspast39 · C'est des conneries : j'ai passé au crible le fil sur la programmation des poids d'Astra et leurs propres journaux, puis j'ai testé moi-même. « Les maths jusqu'à 6 fois » — ils font tourner qwen 0.8B en mode réflexion. La propre fiche modèle de qwen indique que ce mode boucle — il tape « attends
@signulll · c'est comme si ton prof de maths corrigeait ton examen, décidait quels neurones sont responsables de tes conneries/de ta stupidité, t'ouvrait le crâne et les réparait directement.
Sankalp / @dejavucoder · astra après avoir opéré qwen3.5-0.8b et l’avoir rendu 6 fois meilleur en maths et 3 fois meilleur pour suivre les instructions, genre : « voici mon quant »
Jürgen Schmidhuber / @schmidhuberai · C'est du déjà-vu. C'est exactement ce que faisaient les programmeurs neuronaux à poids rapides dans les années 1990 (y compris le Transformer linéaire non normalisé de 1991). Présentation générale avec des liens vers les articles d'origine : https://people.idsia.ch/...
@realastropulse · C'est incroyablement trompeur. Non, le modèle n'a pas modifié les poids bruts. Il a utilisé des outils existants pour repérer une zone problématique du modèle, puis a trouvé la direction qui lui était associée et l'a supprimée du modèle. La façon de survendre cette découverte est franchement malhonnête intellectuellement.
Omar Khattab / @lateinteraction · comme pour le premier article de blog de RLM, il y a presque exactement un an, le coût total de ce travail pour Rikiya s'est élevé à environ 1 000 $ tout compris
@yoavgo · c’est assez dingue et très intéressant, lisez ça ! mais, comme je ne crois pas que les LLM soient des généralisateurs magiques dotés de capacités émergentes, ça me fait surtout penser : « mais sur quoi diable openai a entraîné ces modèles ». (et je suis curieux de voir les performances de claude sur ces tâches)
Arjun Jain / @arjunjain · Pendant toute ma thèse, l'argument contre les réseaux de neurones était simple : personne ne peut lire les poids. La nuit dernière, un modèle a lu les poids d'un autre et en a modifié 0,016 %. Pas de gradients, pas d'entraînement. Les résultats en maths sont passés de 7,9 % à 48,1 %. La boîte noire a enfin un lecteur. Ce n'est pas nous.
Pavel Mayer / @pavel23 · Autre capacité étrange et inattendue des LLM : la programmation de l’espace des poids. Comprendre ce que fait un réseau neuronal en lisant ses poids, sans l’exécuter, et créer un réseau neuronal fonctionnel sans l’entraîner. https://rikiyat.github.io/...
Jayden Teoh / @jayden_teoh_ · l’interprétabilité mécanistique et l’optimisation, telles que nous les connaissons, pourraient peut-être toucher à leur fin. les agents comprendront fondamentalement mieux que nous les valeurs numériques des poids, que ce soit de manière émergente ou grâce à l’entraînement par RL. il est temps de repenser l’effort qu’il vaut la peine de consacrer à la découverte des comportements neurone par neurone, plutôt que d...
Shashank / @0xshai · Des résultats totalement incroyables. Par analogie, c’est comme si un spécialiste des fusées réorganisait les neurones d’un quidam pour en faire un spécialiste des fusées. C’est vraiment un truc de matrices : https://rikiyat.github.io/... [image]
Sur Bluesky
Alejandra Caraballo / @esqueer.net · Un nouvel article explique comment les derniers modèles LLM peuvent désormais modifier et manipuler directement les poids des modèles de réseaux neuronaux pour obtenir des résultats ciblés, comme améliorer l’exécution de tâches. C’est une nouvelle capacité émergente. — rikiyat.github.io/blog/weight- ...
@philpax.me · mais quoi, les LLM de pointe peuvent interpréter directement les poids de modèles plus petits et les modifier rikiyat.github.io/blog/weight- ...