Ethan Mollick / @emollick · Je pense que, contrairement à ce que beaucoup d’entre nous attendaient, nous n’avons pas vu de modèle open source de classe Fable plus de huit mois après la présentation publique de Fable/Mythos.
@kimmonismus · Qwen 4 n’est pas une bonne sortie. Bien qu’il semble, sur le papier, rivaliser avec Opus 5.5 dans les principaux benchmarks, l’AA Index brosse un tableau complètement différent. Le fait que Qwen soit privé de distillation semble illustrer cet échec.
Jack Patrick / @solivagant7777 · Les modèles chinois de pointe font tout leur possible pour atteindre tout juste le niveau de Haiku. 💀
Mert Gulsun / @mert_gulsun · [avis personnel] On est peut-être dans cette intéressante « période intermédiaire » où les puces et les chaînes de traitement des données chinoises n'ont pas encore rattrapé celles des États-Unis. De plus, l'écart de puissance de calcul sera plus important l'année prochaine. Les résultats ne sont donc pas surprenants à mes yeux. En tant qu'utilisateur assidu des modèles 27B de Qwen et d'autres modèles pour la recherche, j'attendrai patiemment des modèles plus petits, quoi qu'il en soit. [publication citée]
@steadeepanda · @ArtificialAnlys @ArtificialAnlys Qu'est-il arrivé aux plus de 700 modèles que vous aviez ? Ils n'apparaissent plus dans la liste. C'était un bon moyen de suivre et de voir les progrès. L'interface change aussi de temps en temps ; un peu de stabilité nous aiderait sûrement.
Adam / @amjustadam · @ArtificialAnlys Ça leur a pris tellement de temps… Je m'attendais à mieux, franchement.
Chris MM / @cmm_ai_ · @ArtificialAnlys Je m'attendais à beaucoup plus de la part de Qwen4 Max, mais ce n'est pas mal.
@tech2wild · Euh.... C’est dingue de voir à quel point ces nouveaux benchmarks classent désormais les modèles chinois...
@hesamation · Le score d'intelligence d'AA et le coût par tâche ne sont pas les meilleurs https://x.com/... [publication citée]
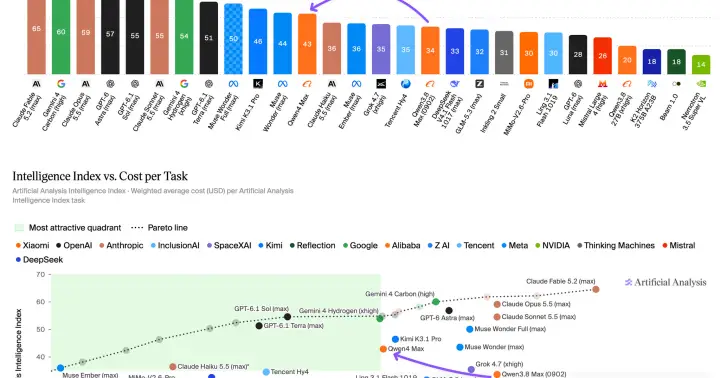
@artificialanlys · Qwen4 Max obtient 9 points de plus que Qwen3.8 Max à l'Intelligence Index, tout en utilisant 39 % de tokens de sortie en moins par tâche (~105k contre ~171k)
Anika / @anikacodes · Qwen4-Max est passé de 34 à 43 sur l’Artificial Analysis Intelligence Index. Le coût par tâche est passé de 10,02 $ à 3,27 $. Grosse mise à niveau. Mais pour à peu près le même prix, Gemini 4 Hydrogen obtient 54. Mon post sur les prix publié plus tôt aurait mérité une note de bas de page 😅
@dogukanurker · Honnêtement, je m’attendais à un plus gros bond de qwen4-max. +9 par rapport à 3.8, c’est solide, mais il n’a toujours pas réussi à dépasser kimi k3.1 pro ou muse wonder, et opus 5.5 a 16 points d’avance. Ça m’inquiète aussi pour qwen4-27b. Les gens disaient qu’il pourrait se situer autour du niveau d’opus 5, mais opus 5 est à 44 et max lui-même e...
@beamsters1 · Qwen sort du grand groupe des modèles de milieu de gamme pour rejoindre le groupe des suiveurs de pointe, où seuls Muse et Kimi figuraient jusqu’ici.
Haider / @haider1 · qwen 4 semble étonnamment décevant vu tout le battage autour, je ne sais pas si « l’exponentielle » est réelle, mais on dirait clairement que les grands labos fermés font des progrès plus importants et plus rapides ces derniers temps, tandis que les labos chinois peinent à suivre. j’imagine que les grands labos profitent déjà de la pseudo-RSI [publication citée]
@alibaba_qwen · +9 points par rapport à Qwen3.8-Max pour un coût inférieur. Essayez-le ! @ArtificialAnlys [publication citée]
Keith Jordan / @pyronisai · @ArtificialAnlys Je ne suis plus sûr de croire aux benchmarks d'AA. Ils me semblent trop biaisés. Je me trompe peut-être, mais je les lance tous et je n'obtiens pas les mêmes résultats. Peut-être qu'on a dépassé le stade où les benchmarks sont utiles.
@jmbollenbacher · Honnêtement, ça n’inspire pas confiance dans les nouveaux modèles Qwen. J’espère que Flash et 27B seront meilleurs que Max dans leurs catégories de taille. Historiquement, c’est le cas, alors espérons que ça continue. [publication citée]
@redstapler_twit · C’est juste moi, ou depuis qu’Anthropic a bloqué la distillation, le rythme de développement des modèles chinois a considérablement ralenti et l’écart avec les modèles de pointe s’est creusé ?
Blake / @blakeothy · Regardez ça. 9 points ! On est loin d'Opus 5.5, mais on progresse.
@techmdai · Qwen 4 max passe à 43. Je ne pense toujours pas que ces évaluations soient exactes [image] [publication citée]
@artificialanlys · Analyse détaillée des résultats de Qwen4 Max dans les différentes évaluations de l'Artificial Analysis Intelligence Index
@artificialanlys · Qwen4 Max coûte 3,27 $ par tâche de l'Intelligence Index, soit 67 % de moins que Qwen3.8 Max (10,02 $) et moins que Kimi K3.1 Pro (max, 3,68 $), qui obtient un score supérieur de 3 points. Tencent Hy4 est moins cher, à 1,03 $, mais obtient un score inférieur de 8 points. La baisse par rapport à Qwen3.8 Max s'explique à la fois par une diminution...
John / @johnmckeownn · C'est un score honnête, mais bon sang, l'open source peine à combler l'écart en ce moment. Maintenant, la fuite de GPU vers la Chine est sous le feu des projecteurs : comment vont-ils s'en sortir avec ce qu'ils ont déjà ?